主な特徴
使える場面
- サイト内容を集めてAIツールに渡す
- 複数サイトの情報を保存にまとめる
- 分析プロジェクト向けにウェブ情報を収集する
使い方
- 1 クレジットカードなしでアカウント登録する
- 2 対象URLを指定して抽出リクエストを送る
- 3 MarkdownやHTMLなど出力形式を選ぶ
- 4 Webhookでタスクの状態を追う
- 5 抽出データを保存または書き出す
こんな方におすすめ
メリット
- 開始時に25ドル分の無料クレジット
- 整形済みの出力形式が複数
- 描画によりJavaScript多用サイトにも対応
制限事項
- 無料クレジットには上限があり、大量処理には有料利用が必要
- スクレイピングはサイト規約と法規を守る必要があり、責任は利用者にある
- 複雑なページではセレクター調整がまだ必要
UseScraper Crawler とは
UseScraperは、高速なウェブクローラーとデータ抽出APIです。ページ内容を取得してHTML、平文、Markdownの形で返し、JavaScriptを多用するサイトにはブラウザ描画を使います。複数のウェブサイトを同時にスクレイピングできる点も特徴です。特定のURLを除外したり、CSSセレクターで重複した内容を取り除いたり、Webhookでジョブの状態を受け取ったりできます。保存したデータは自動的に失効します。新規利用者はクレジットカードなしで登録でき、25ドル分の無料クレジットをもらえるので、支払い前に動作を試せます。
できること
- ページを整形済みのMarkdown、平文、HTMLで取得する
- 描画を行ってJavaScript依存のサイトを処理する
- 複数の抽出ジョブを同じタイミングで走らせる
- Webhookで進行状況を追い、データは失効まで保管する
こんな人に向いています
- ウェブ内容をAIやデータ処理の流れに渡す開発者
- 多数のサイトから情報を集めるアナリスト
- コンテンツ抽出を自動化したいチーム
注意点
無料クレジットには限りがあるため、処理量が増えれば有料利用になり、料金も変わり得ます。スクレイピングは対象サイトの規約と関係法令を守って行う必要があり、集めたデータをどう扱うかも含めて責任は利用者にあります。複雑なページでは、望む形で抽出するためにセレクターの調整がまだ必要になることがあります。そのため、本番で使う前に設定と試験の時間を見込んでください。最初は小さな対象で試し、出力を丁寧に確認してから重要な作業に進むのが安心です。無料範囲も時間とともに変わることがあるため、常用する前に公式ページの現在の上限を確認してください。結果が期待と違う場合は、指定内容や設定を見直して再実行してください。
よくある質問
無料クレジットはありますか。
サイトによれば、クレジットカードなしで登録でき、開始時に25ドル分の無料クレジットが得られます。
どんな出力形式ですか。
抽出したページから、整形済みのMarkdown、平文、HTMLを返します。
JavaScriptを多用するサイトも扱えますか。
はい。ブラウザ描画に対応しているため、JavaScriptで内容が表示される複雑なサイトもスクレイピングできます。
無料で使える理由
公式ページの記載内容: 免费使用免费zh-継承済み
無料の上限、トライアル期間、機能は公式サイトが決定し、いつでも変更される場合があります。
製品プレビュー
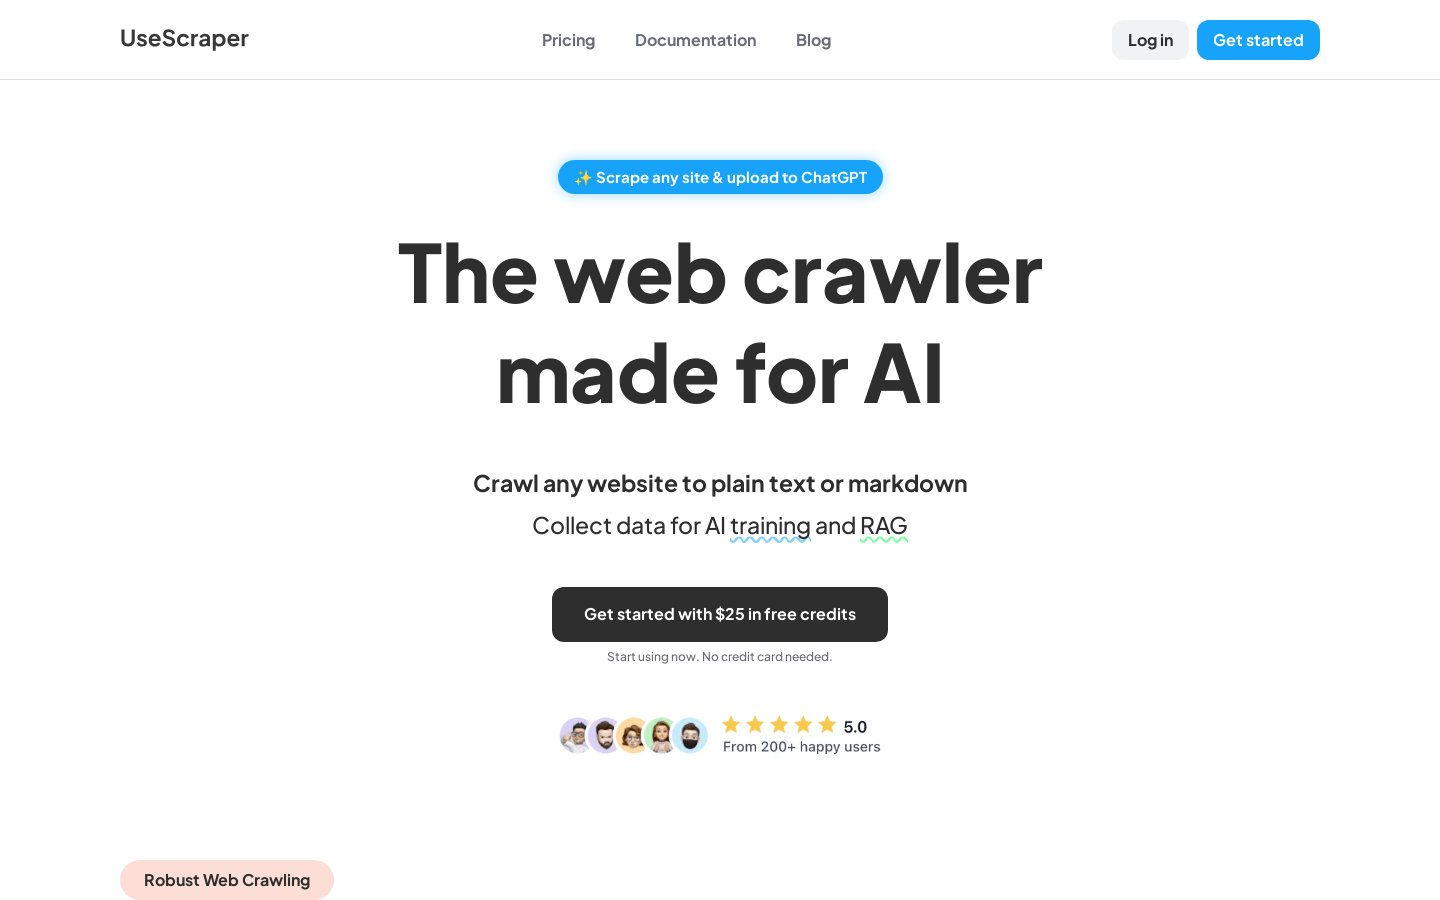
一覧ページから保存したスクリーンショットです。プレビュー専用です。